Home › Forums › Fórum Machine Learning e Data Science com Python de A à Z › Adicionar Novo Registro com Variável Categórica › Reply To: Adicionar Novo Registro com Variável Categórica
23 de abril de 2021 at 20:39
#28479

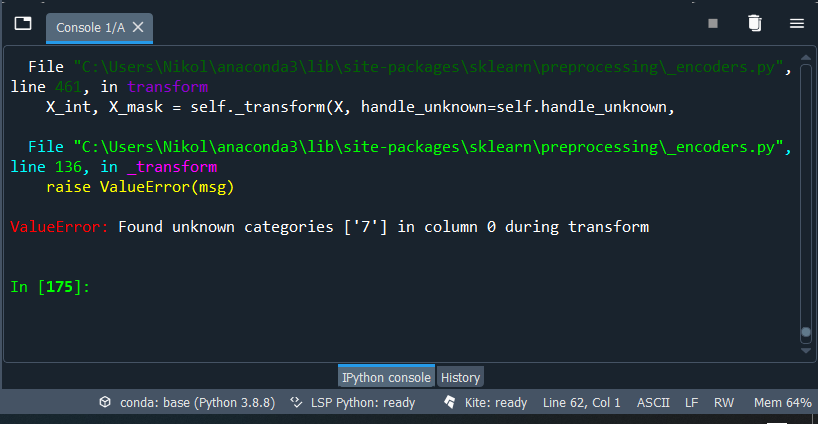
Eu tentei realizar essas mudanças Denny mas não funcionou. Ao tentar fazer o column_tranformer ele acusa o erro da imagem. Dei uma pesquisada e alguns lugares falava para utilizar o OneHotEncoder(handle_unknown=’ignore’), mas não funcionou.
import pandas as pd
import pickle
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler
import numpy as np


base = pd.read_csv('census.csv')
previsores = base.iloc[:, 0:14].values
classe = base.iloc[:, 14].values

from sklearn.preprocessing import LabelEncoder, OneHotEncoder
from sklearn.compose import ColumnTransformer

labelencoder_previsores1 = LabelEncoder()
labelencoder_previsores3 = LabelEncoder()
labelencoder_previsores5 = LabelEncoder()
labelencoder_previsores6 = LabelEncoder()
labelencoder_previsores7 = LabelEncoder()
labelencoder_previsores8 = LabelEncoder()
labelencoder_previsores9 = LabelEncoder()
labelencoder_previsores13 = LabelEncoder()


previsores[:,1] = labelencoder_previsores1.fit_transform(previsores[:,1])
previsores[:,3] = labelencoder_previsores3.fit_transform(previsores[:,3])
previsores[:,5] = labelencoder_previsores5.fit_transform(previsores[:,5])
previsores[:,6] = labelencoder_previsores6.fit_transform(previsores[:,6])
previsores[:,7] = labelencoder_previsores7.fit_transform(previsores[:,7])
previsores[:,8] = labelencoder_previsores8.fit_transform(previsores[:,8])
previsores[:,9] = labelencoder_previsores9.fit_transform(previsores[:,9])
previsores[:,13] = labelencoder_previsores13.fit_transform(previsores[:,13])

column_tranformer = ColumnTransformer([('one_hot_encoder', OneHotEncoder(), [1, 3, 5, 6, 7, 8, 9, 13])],remainder='passthrough')
previsores = column_tranformer.fit_transform(previsores).toarray()

labelencoder_classe = LabelEncoder()
classe = labelencoder_classe.fit_transform(classe)

from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
previsores = scaler.fit_transform(previsores)

mlp = pickle.load(open('mlp_final.sav', 'rb'))
resultado_mlp = mlp.score(previsores, classe)

novo_registro = [[39," State-gov",77516," Bachelors",13," Never-married"," Adm-clerical"," Not-in-family"," White"," Male",2174,0,40," United-States"]]
novo_registro = np.asarray(novo_registro)


novo_registro[:,1] = labelencoder_previsores1.transform(novo_registro[:,1])
novo_registro[:,3] = labelencoder_previsores3.transform(novo_registro[:,3])
novo_registro[:,5] = labelencoder_previsores5.transform(novo_registro[:,5])
novo_registro[:,6] = labelencoder_previsores6.transform(novo_registro[:,6])
novo_registro[:,7] = labelencoder_previsores7.transform(novo_registro[:,7])
novo_registro[:,8] = labelencoder_previsores8.transform(novo_registro[:,8])
novo_registro[:,9] = labelencoder_previsores9.transform(novo_registro[:,9])
novo_registro[:,13] = labelencoder_previsores13.transform(novo_registro[:,13])


novo_registro = column_tranformer.transform(novo_registro).toarray()

novo_registro = scaler.transform(novo_registro)

resposta_mlp = mlp.predict(novo_registro)